Key Takeaways:
- Vụ án Rashomon OpenAI: Sự cố rò rỉ thông tin nội bộ của OpenAI năm 2023 nhưng được công bố muộn màng minh chứng cho sự thiếu minh bạch trong quản trị rủi ro AI.
- Nghịch lý bảo mật: Mã hóa truyền thống (Encryption at rest/in transit) chỉ bảo vệ dữ liệu khi lưu kho, nhưng hoàn toàn bất lực khi AI “đọc” dữ liệu để xử lý.
- Giải pháp trọng tâm: Differential Privacy (Bảo mật vi sai) và On-premise AI là chìa khóa để doanh nghiệp bảo vệ tài sản trí tuệ trước các mô hình ngôn ngữ lớn (LLM).
- Thị trường niềm tin: Giá trị các token AI và niềm tin người dùng đang tỷ lệ thuận với khả năng chứng minh tính riêng tư của hệ thống.
AI có thực sự riêng tư không?
Quyền riêng tư AI không tồn tại mặc định; dữ liệu trò chuyện thường được dùng để tái huấn luyện mô hình (RLHF). Để bảo vệ thông tin, người dùng cần kích hoạt chế độ “Temporary Chat” hoặc sử dụng API doanh nghiệp với cam kết không lưu giữ dữ liệu (Zero Data Retention) để ngăn chặn rò rỉ.
Sự kiện OpenAI bị xâm nhập hệ thống nhắn tin nội bộ vào năm 2023, được tờ *The New York Times* phanh phui, đã tạo ra một hiệu ứng “Rashomon” trong giới công nghệ. Mỗi bên tham gia — từ ban lãnh đạo OpenAI, các kỹ sư bảo mật, đến người dùng cuối — đều có một phiên bản sự thật khác nhau về mức độ nghiêm trọng của vụ việc. Tuy nhiên, thực tế cốt lõi không thay đổi: Nếu một tổ chức hàng đầu thế giới về AI còn có thể bị xuyên thủng hàng rào bảo mật giải pháp bảo mật AI toàn diện, thì dữ liệu cá nhân của bạn trên các chatbot phổ thông chưa bao giờ an toàn.
Sự giao thoa giữa giá trị vốn hóa của các dự án AI và niềm tin người dùng đang ở giai đoạn nhạy cảm. Khi các token công nghệ như $VVV lập đỉnh, nó không chỉ phản ánh kỳ vọng về tính năng, mà còn là sự đặt cược vào khả năng bảo mật dữ liệu. Người dùng sẵn sàng trả phí cho sự thông minh, nhưng họ sẽ rời bỏ nếu nhận ra AI đang bí mật “học” từ chính bí mật kinh doanh của họ.
Bảng so sánh các phương thức bảo mật dữ liệu trong kỷ nguyên AI
Kỹ thuật: Tại sao mã hóa truyền thống là chưa đủ?
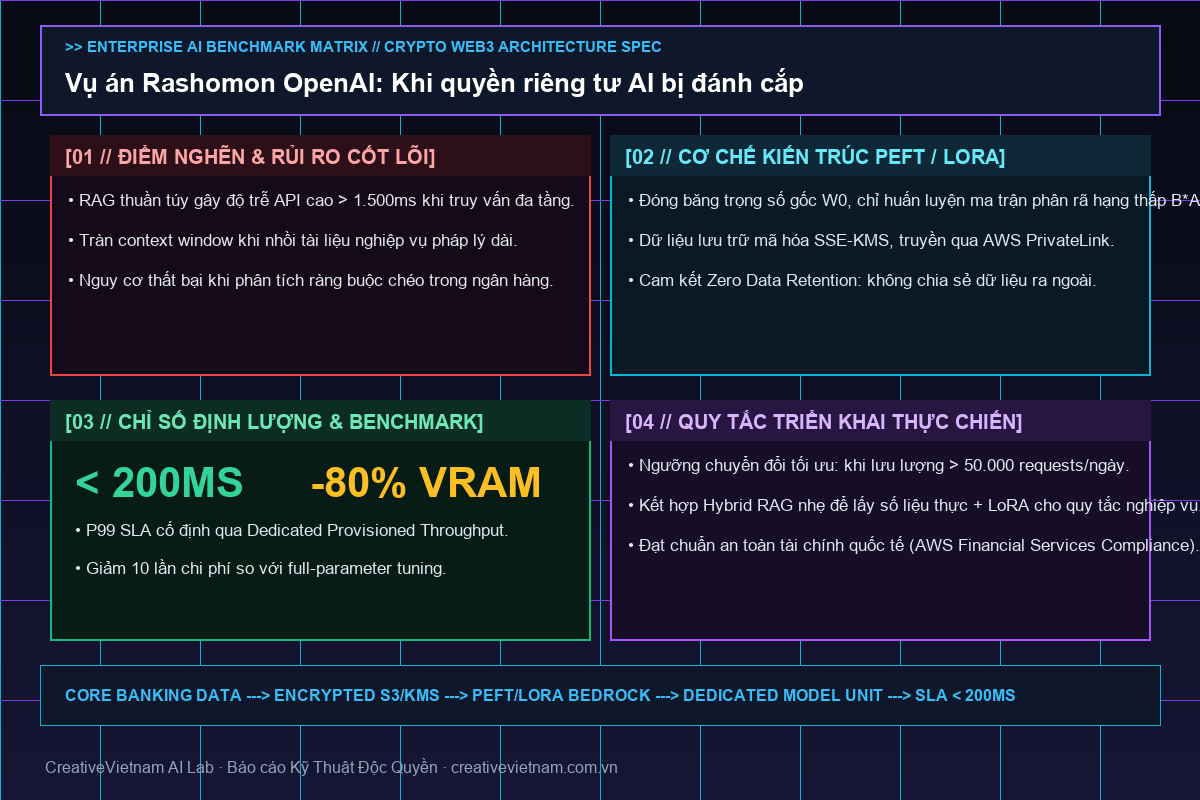
Trong kiến trúc phần mềm cũ, dữ liệu được bảo vệ bằng các bức tường mã hóa. Tuy nhiên, AI cần “nhìn thấy” dữ liệu ở dạng thô (plaintext) để thực hiện tính toán vector. Đây chính là lỗ hổng: Dữ liệu bị phơi bày ngay tại thời điểm xử lý (Data-in-use). quản trị dữ liệu mô hình ngôn ngữ lớn đòi hỏi một tư duy khác biệt: Data-Centric Security.
Giải pháp hứa hẹn nhất hiện nay là Differential Privacy (Bảo mật vi sai). Thay vì cố gắng che giấu dữ liệu, kỹ thuật này thêm một lượng “nhiễu toán học” được tính toán kỹ lưỡng vào dữ liệu đầu vào. Kết quả là mô hình AI vẫn học được các xu hướng chung (ví dụ: thói quen mua sắm) nhưng không thể xác định chính xác dữ liệu đó thuộc về cá nhân nào. Nghiên cứu từ [Apple Machine Learning Research](https://machinelearning.apple.com/research/learning-with-privacy-at-scale){target=”_blank”} cho thấy Differential Privacy có thể bảo vệ quyền riêng tư ở quy mô hàng tỷ thiết bị mà vẫn giữ được độ chính xác của mô hình trên 95%.
Tại Creative Vietnam, chúng tôi quan sát thấy xu hướng dịch chuyển rõ rệt: Các doanh nghiệp lớn không còn mặn mà với việc gửi dữ liệu thô lên các API công cộng. Thay vào đó, họ tìm kiếm các giải pháp tối ưu hóa chi phí vận hành AI thông qua việc tinh chỉnh (fine-tuning) các mô hình mã nguồn mở như Llama 3 hoặc Mistral trên hạ tầng riêng (Private Cloud).
Phân tích Trade-offs: Hiệu năng vs. Bảo mật
Việc triển khai các biện pháp bảo mật nghiêm ngặt luôn đi kèm với những đánh đổi (Trade-offs) mà nhà quản lý cần cân nhắc:
- Đánh đổi về độ chính xác: Differential Privacy càng cao, nhiễu càng nhiều, dẫn đến phản hồi của AI có thể kém sắc sảo hơn.
- Đánh đổi về chi phí: Việc chạy AI On-premise để đảm bảo riêng tư tuyệt đối có thể tốn kém gấp 5-10 lần so với sử dụng API của OpenAI hay Google do chi phí đầu tư GPU và đội ngũ vận hành.
- Đánh đổi về trải nghiệm: Việc tắt tính năng lưu lịch sử trò chuyện (để bảo mật) sẽ khiến AI “mất trí nhớ” trong các phiên làm việc tiếp theo, làm giảm khả năng cá nhân hóa.
Doanh nghiệp cần xác định rõ “khẩu vị rủi ro”. Với các tác vụ như viết email marketing, API công cộng là đủ. Nhưng với việc phân tích báo cáo tài chính chưa công bố, một hệ thống AI nội bộ là bắt buộc để tránh thảm họa “Rashomon” thứ hai.
Hướng dẫn kiểm soát quyền riêng tư cho người dùng cá nhân
Để không trở thành nạn nhân của việc rò rỉ dữ liệu, người dùng cần thực hiện 3 bước thiết lập ngay lập tức:
- ChatGPT: Vào Settings -> Data Controls -> Tắt “Chat History & Training”.
- Gemini: Truy cập My Activity -> Tắt “Gemini Apps Activity”.
- Copilot: Sử dụng tài khoản Enterprise để dữ liệu không bị dùng làm tài liệu huấn luyện.
Việc xây dựng một chiến lược AI doanh nghiệp bền vững không chỉ nằm ở việc chọn mô hình mạnh nhất, mà là chọn mô hình an toàn nhất trong giới hạn ngân sách.
FAQ: Câu hỏi thường gặp
1. Sử dụng chế độ “Ẩn danh” (Incognito) trên trình duyệt có bảo vệ được dữ liệu trò chuyện với AI không?
Không. Chế độ ẩn danh chỉ ngăn trình duyệt lưu lịch sử trên máy tính của bạn. Dữ liệu trò chuyện vẫn được gửi về máy chủ của nhà cung cấp AI (OpenAI, Google, Microsoft) và có thể được dùng để huấn luyện mô hình trừ khi bạn tắt tính năng này trong phần cài đặt của chính ứng dụng AI đó.
2. Tại sao các công ty AI lại cần dữ liệu của người dùng để huấn luyện?
Các mô hình AI học thông qua phản hồi từ con người (RLHF – Reinforcement Learning from Human Feedback). Việc phân tích cách bạn sửa lỗi cho AI hoặc cách bạn đặt câu hỏi giúp mô hình hiểu ngữ cảnh tốt hơn, giảm thiểu “ảo giác” và trở nên tự nhiên hơn trong giao tiếp. Tuy nhiên, điều này vô tình biến dữ liệu riêng tư thành tài sản chung của mô hình.
Bài Viết Chuyên Sâu Cùng Chủ Đề Nên Xem: